Physical AI
피지컬 AI에서 모델 선택은 작업 그 자체에서 시작됩니다
물리적 시스템에서는 정확한 답만으로 충분하지 않습니다. 그 답이 언제, 어떤 하드웨어에서 행동으로 이어지는지도 중요합니다. 모델 선택, 토큰 경제성, VLM/VLA 아키텍처를 현장의 관점에서 살펴봅니다.
 Alp Eren ÖzalpR&D 및 소프트웨어 개발 부사장
로봇은 움직이는 부품의 위치를 정확히 파악하더라도, 그것을 잡으려고 움직이는 순간에는 이미 늦었을 수 있습니다. 화면에서는 정답이라고 할 수 있는 응답이 물리적 환경에서 실제로 효과를 내는지는, 그 응답이 언제 그리고 어떤 하드웨어로 행동으로 옮겨지는지에도 달려 있습니다. 그래서 저희는 피지컬 AI에서 모델 선택을 작업에 필요한 역량을 정의하는 것부터 시작합니다. 모든 결정을 가장 큰 모델에 맡긴다고 해서, 작업 동안 소비되는 토큰과 사용되는 하드웨어만큼의 가치를 얻는 것은 아닙니다.
Cerebrum Tech는 보험 업계 고객사의 자동차 손해 사정 시나리오에서 Qwen/Qwen3.8-27B 모델을 파인튜닝하여 95%의 정확도로 Claude Opus 5.5 수준에 도달했으며, 조치 시간을 50% 단축하는 동시에 토큰 비용을 80% 절감했습니다. 이 경험은 작업에 맞춘 적응이 모델 선택에서 얼마나 결정적일 수 있는지를 보여 주었습니다. 진행 중인 피지컬 AI R&D 역시 같은 관점으로 접근하고 있습니다. 인식과 동작 계획처럼 서로 다른 작업에 필요한 정확도, 지연 시간, 하드웨어 요구 사항을 함께 평가합니다. 토큰 경제성 또한 대체하게 될 기존 시스템과 비용을 비교하기 위한 기준으로 다룹니다.
토큰 가격에서 작업 비용으로
토큰 경제성을 단가 기준으로 이야기하기는 쉽습니다. 하지만 저렴한 응답이 곧 작업이 저렴하게 끝났다는 뜻은 아닙니다. 재시도, 사람의 검토, 잘못된 출력을 바로잡는 데 드는 시간은 올바른 결정 하나당 총비용을 바꿀 수 있습니다. 더 강력한 모델이 한 번에 끝내는 일을 더 작은 모델이 여러 번 시도해야 끝낸다면, 가격표상의 이점은 사라질 수 있습니다.
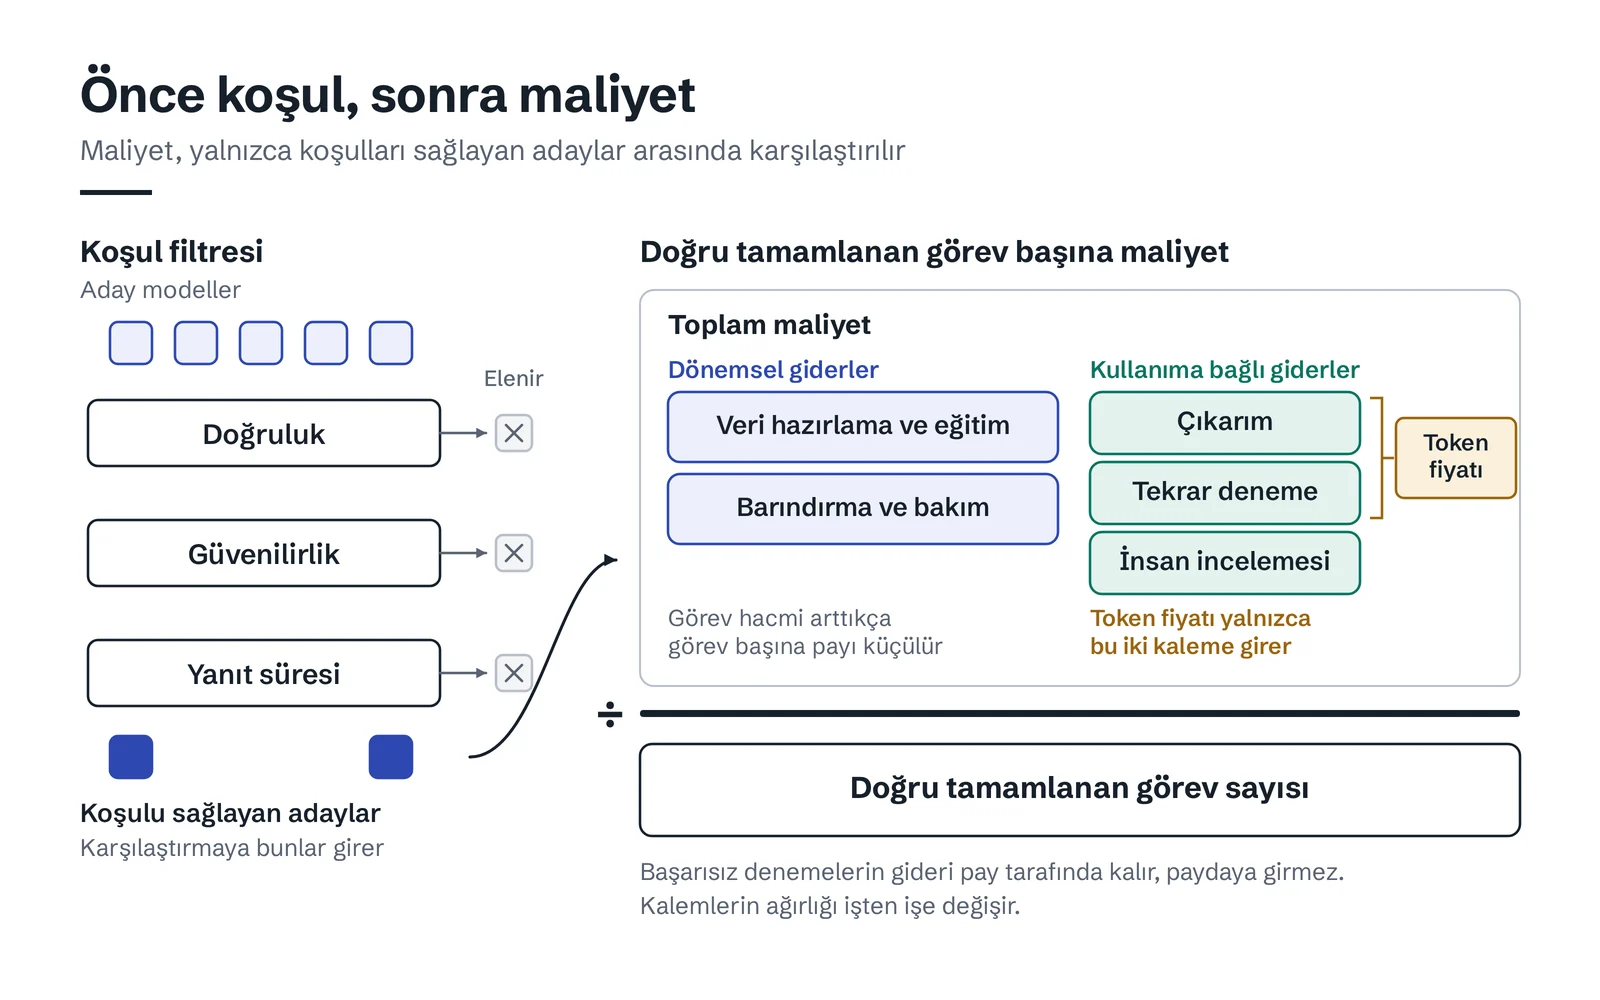
결정을 내릴 때는 먼저 작업과 허용할 수 없는 오류를 정의합니다. 그다음 요구되는 정확도, 신뢰성, 응답 시간을 충족하지 못하는 선택지를 제외합니다. 비용은 이 조건을 충족하는 모델들 사이에서만 비교합니다. 물리적 시스템에서 더 낮은 비용을 위해 안전 조건을 완화하는 것은 선택지로 고려하지 않습니다.
파인튜닝이 언제나 경제적인 것도 아닙니다. 데이터 준비와 학습에는 초기 비용이 들고, 호스팅과 유지 보수 비용은 사용 기간 내내 이어집니다. 작업이 충분히 반복된다면 특화에 대한 투자가 그 값을 할 수 있습니다. 물량이 적거나, 작업이 자주 바뀌거나, 데이터 준비 비용이 높다면 강력한 범용 모델이 더 경제적일 수 있습니다. 자동차 손해 사정 프로젝트는 저희가 작업 맞춤 적응을 선택지에 남겨 두는 이유를 설명해 줍니다. 다른 작업이라면 선택을 다시 평가해야 합니다.
피지컬 AI에서 비용을 계산할 때는 완료된 물리적 작업도 기준으로 삼아야 합니다. 로봇이 몇 번이나 파지를 시도하는지, 얼마나 기다리는지, 작업자가 얼마나 자주 개입하는지가 운영 비용에 반영됩니다. 모델의 추론 비용을 줄이면서 생산 사이클을 늘린다면, 결과적으로 전체적으로 더 비싼 시스템이 될 수 있습니다.
이미지를 이해하고, 동작을 만들어 내다
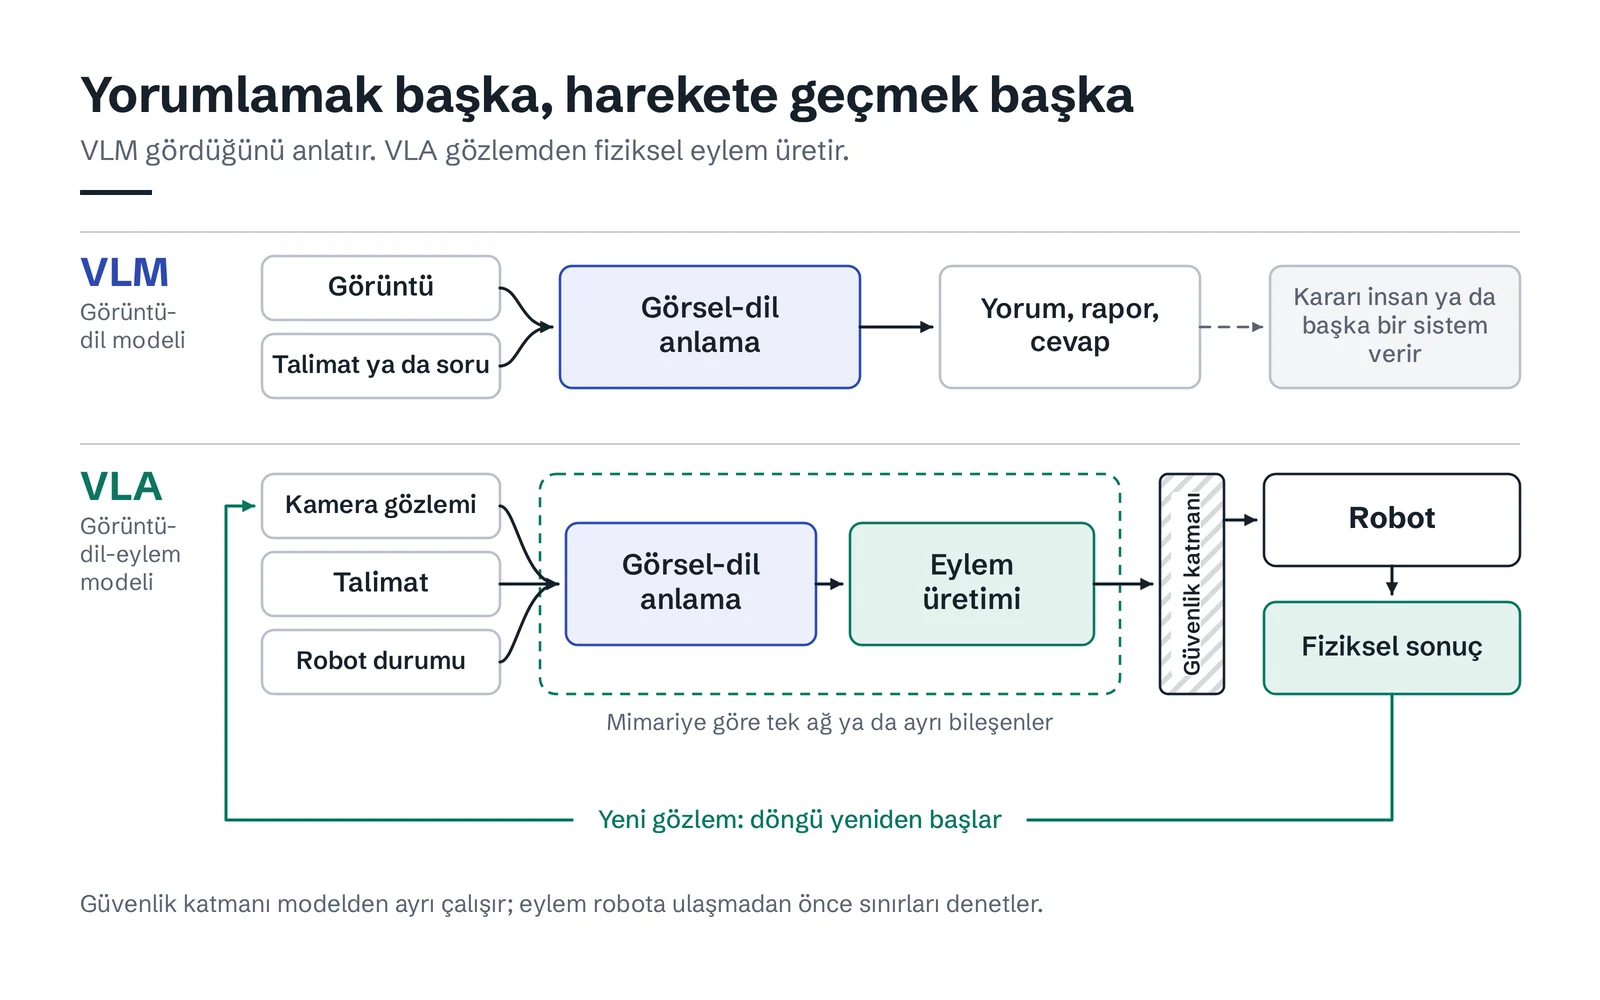
비전-언어 모델, 즉 VLM은 이미지 속 내용을 언어와 연결해 의미를 파악합니다. 비전-언어-행동 모델인 VLA는 시각 정보와 언어 정보를 로봇의 행동과 연결합니다. 부품을 인식하는 것과 그것을 적절한 힘으로 잡는 것 사이에는, 동작 내내 지속적으로 갱신되어야 하는 제어 과정이 있습니다. 저희는 피지컬 AI 연구에서 모델의 역량을 하드웨어 및 제어 과정과 함께 평가합니다.
외부 연구에서도 다양한 엔지니어링 질문에 대한 답을 찾고 있습니다. OpenVLA의 Franka 실험에서 파라미터의 1.4%만 업데이트하는 LoRA 방식으로 전체 파인튜닝 수준에 도달한 것은, 적응에 필요한 학습 자원 측면에서 주목할 만합니다. 이 결과는 모델에 작업 특화 역량을 부여하는 비용을 평가하는 데 중요합니다. 다만 추론에 얼마나 많은 자원이 필요한지는 별도로 측정해야 합니다.
Hugging Face의 SmolVLA 연구에서는 또 다른 접근이 두드러집니다. 로봇이 현재 동작을 수행하는 동안 다음 동작을 미리 계산하는 방식입니다. 이를 통해 대기 시간을 줄이기 위해 모델 크기뿐 아니라 계산의 타이밍까지 함께 다룹니다. 이 사례는 피지컬 AI 아키텍처를 평가할 때 모델 선택과 계산 구성 방식을 함께 살펴봐야 한다는 점을 보여 줍니다. 더 작은 모델을 쓰는 것만으로는 빠른 로봇을 얻을 수 없습니다.
현장이 평가를 바꾼다
BMW 공장에서의 작업에 관한 Figure의 발표는 물리적 시스템에서 하드웨어가 얼마나 결정적인지를 보여 줍니다. Figure 02의 임무는 판금 부품을 용접 지그에 배치하는 것이었습니다. 회사는 1,250시간이 넘는 가동 기간 동안 9만 개 이상의 부품을 적재했다고 밝혔습니다. 같은 발표에서 전완부가 주요 하드웨어 고장 지점으로 언급된 점도 생산 수치만큼이나 중요하다고 봅니다.
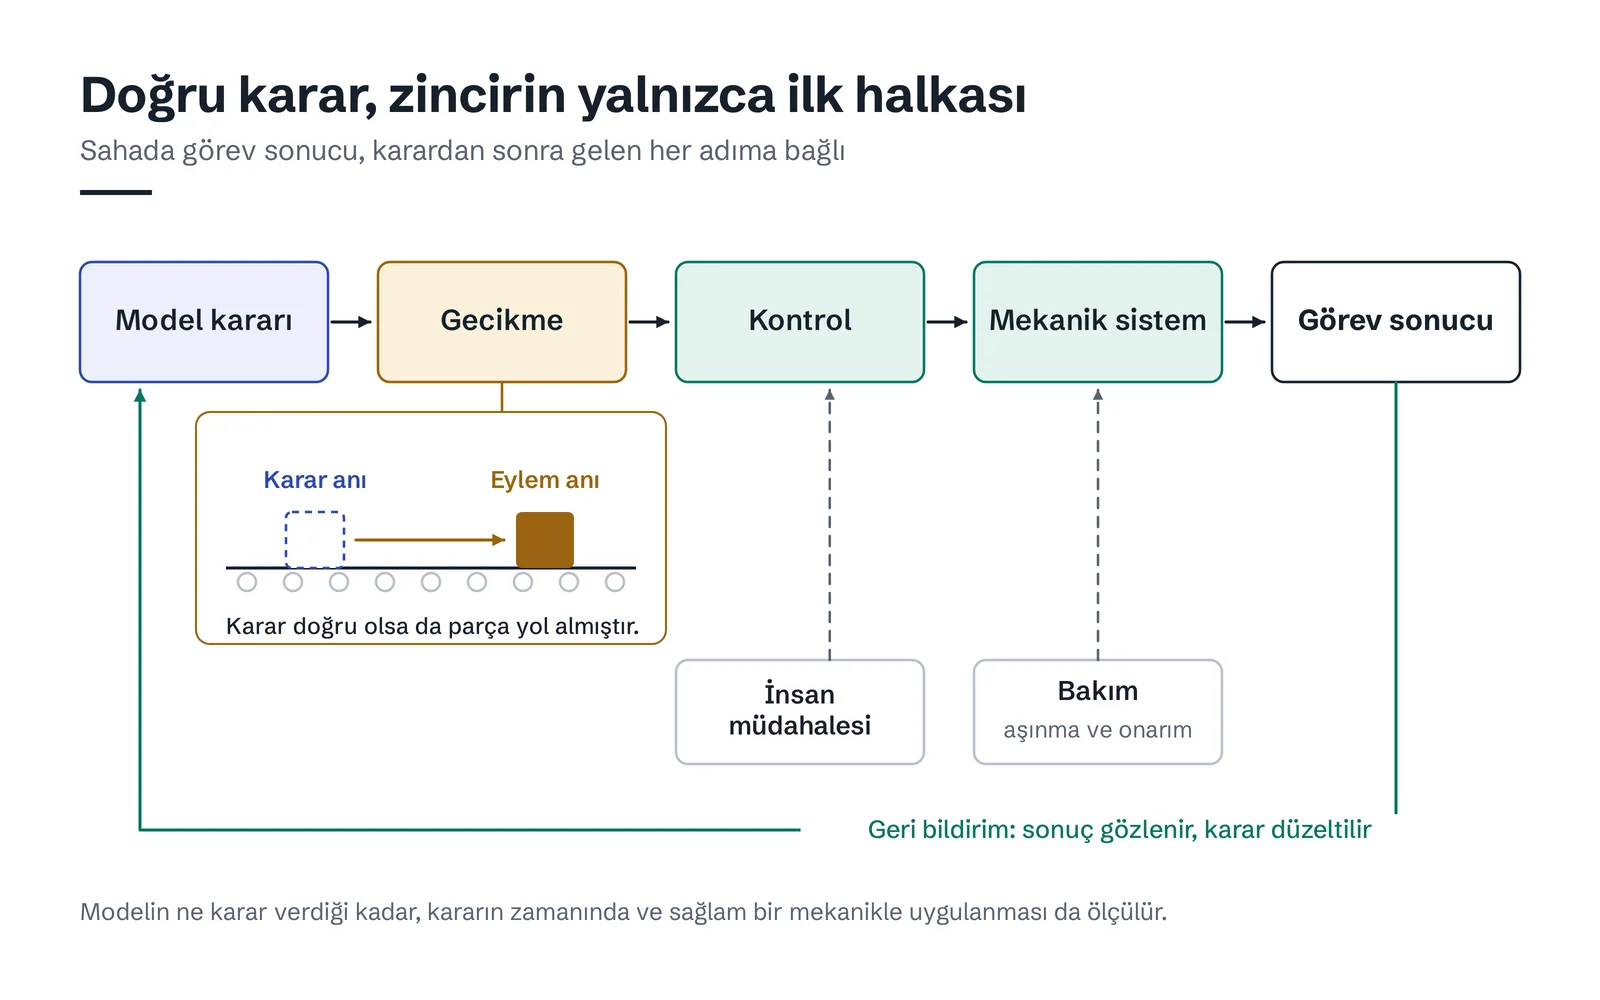
모델이 작업을 정확하게 계획한다고 해서 기계적 내구성 문제가 해결되지는 않습니다. 유지 보수 필요성과 개입 시간이 시스템의 일상적인 가용성을 결정합니다. 안전 또한 계획 모델에 맡길 수 없으며, 동작을 직접 제어하는 제어 시스템 및 하드웨어의 안전 장치와 함께 설계되어야 합니다. 그래서 저희는 피지컬 AI 연구에서 모델 성능과 시스템 신뢰성을 각각 따로 평가합니다.
연구에서 여전히 어려움을 겪는 분야 중 하나는 학습한 기술을 변화하는 환경에서도 사용할 수 있게 하는 것입니다. 물체의 위치나 조명이 바뀌어도 로봇이 작업을 계속할 수 있을까요? 예상치 못한 접촉을 만났을 때는 어떻게 행동할까요? 이러한 질문은 데이터 다양성이 왜 필요한지를 설명해 줍니다. 하나의 환경에서 얻은 결과가 다른 작업 조건에서도 유효하려면 별도의 노력이 필요합니다.
역할 분담이 늘어날 것으로 기대합니다
앞으로는 강력한 계획 모델과 로컬에서 실행되는 특화된 동작 모델을 함께 사용하는 아키텍처가 확산될 것으로 예상합니다. 환경을 해석하는 모델과 실시간 피드백에 빠르게 반응하는 모델이 같을 필요는 없습니다. 역할 분담은 연산 자원을 필요에 따라 배분하고 네트워크 연결에 대한 의존도를 줄이는 데 도움이 될 수 있습니다. 이를 위해서는 모델 간 통신과 오류 처리도 올바르게 구축해야 합니다.
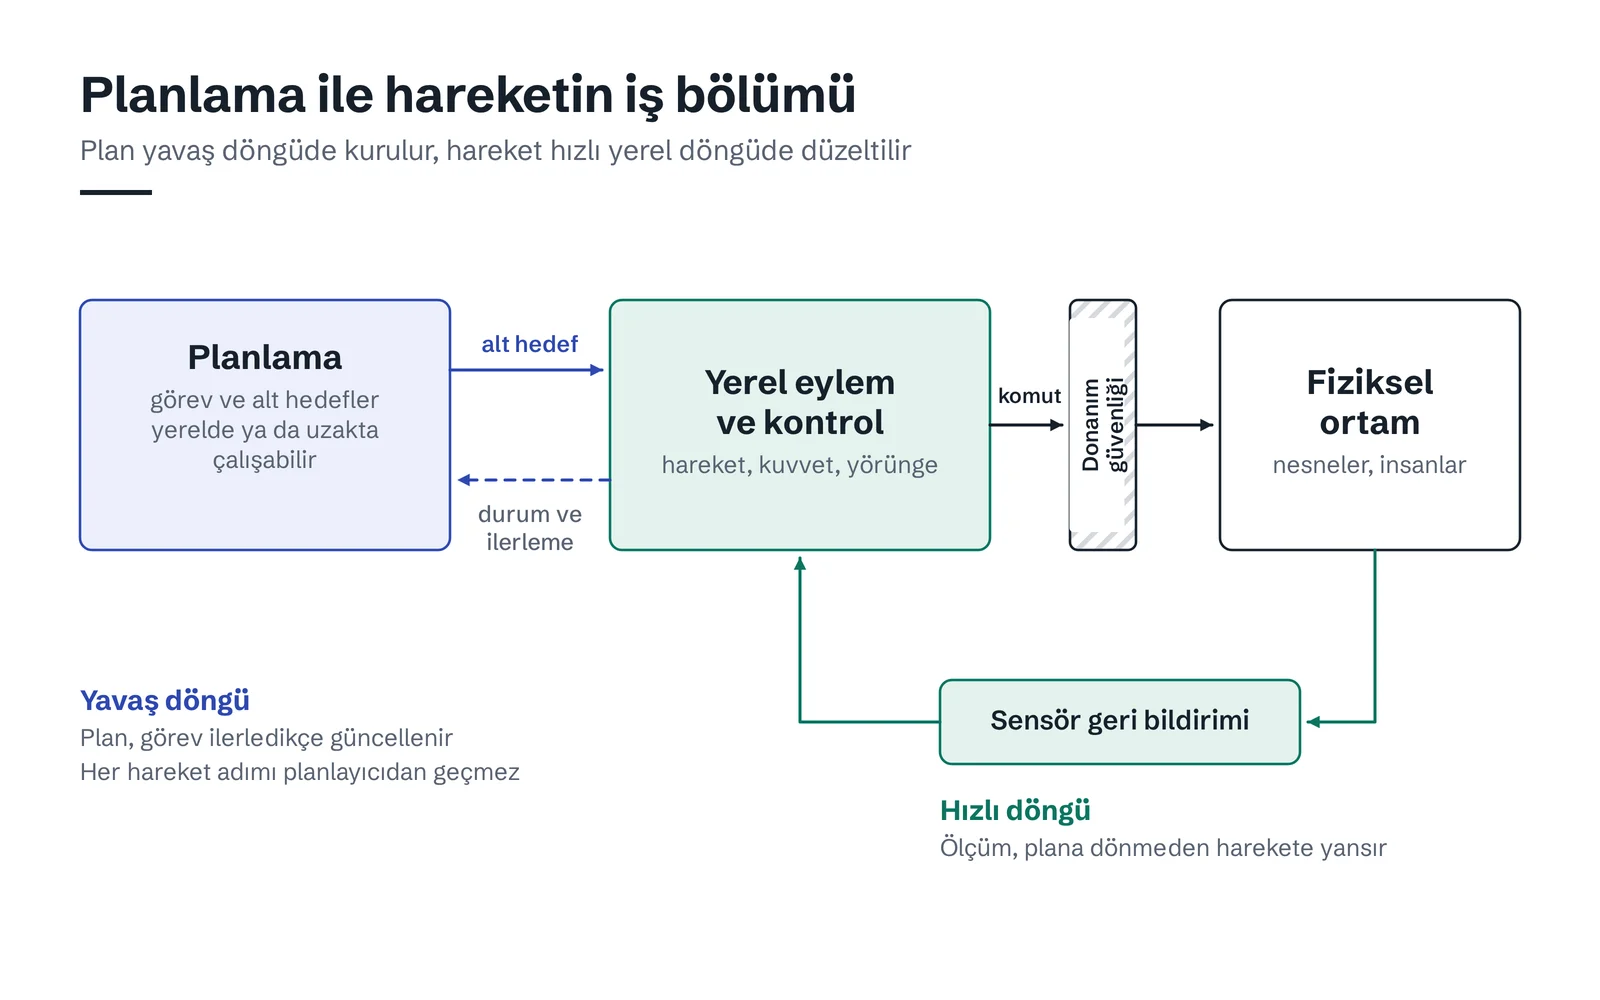
시뮬레이션이 학습에 더 많이 활용될 것으로도 전망합니다. 매번 실제 하드웨어를 위험에 빠뜨리지 않고 다양한 조건을 시험해 볼 수 있다는 점이 학습 과정을 뒷받침합니다. 그러나 접촉, 마모, 지연 시간 같은 요인의 영향은 여전히 실제 하드웨어에서 검증해야 합니다. 기술이 새로운 환경에서도 활용되려면 학습 데이터를 다양화하고 현장 피드백을 학습 과정에 반영하는 것이 결정적일 것입니다.
Cerebrum Tech는 이러한 질문들과 함께 피지컬 AI 연구를 이어가고 있습니다. 자동차 손해 사정 프로젝트에서 확인한 특화의 가능성을 물리적 작업의 다양한 제약을 고려하며 평가하고 있습니다. 모델의 역량뿐 아니라 그것이 하드웨어 및 작업 환경과 어떻게 조화를 이룰지도 이해하려 합니다. 작업이 요구하는 정확도와 안전 조건, 그리고 총비용을 함께 고려하여 기술적 선택을 만들어 가고자 합니다.
참고 자료
- OpenVLA — 연구 사이트 및 파인튜닝 실험
- Hugging Face — SmolVLA: Efficient Vision-Language-Action Model
- Figure — F.02 Contributed to the Production of 30,000 Cars at BMW
- Google DeepMind — Gemini Robotics 2
- Google DeepMind — Gemini Robotics On-Device 2 모델 카드
- Nikhil Sawane — When Fine-Tuning Hurts (2025년 12월 15일)
- Xavier O’Keefe — Fine Tuning SmolVLA for New Environments (2026년 1월 21일)
- Ville Kuosmanen — Sharing GPUs in AI Robotics with CUDA Streams (2025년 10월 13일)
- LG AI Research — RFM: Action-Oriented Intelligence for Physical AI (2026년 6월 26일)
- Ahabb Sheraz — Anatomy of VLA: Inside SmolVLA (2026년 8월 1일)
- Shivam Kumar Singh — Teaching an SO101 to sort blue candies (2026년 10월 19일)