인공지능
Cere-Gemma2-9b: 튀르키예어에 강한 언어 모델
Cerebrum Tech가 미세 조정한 90억 매개변수 모델 Cere-Gemma2-9b의 특징과 사용 방법을 소개합니다.
대규모 언어 모델(LLM)은 오늘날 텍스트 이해, 생성, 번역 등 다양한 작업의 중심에 있습니다. 하지만 대부분의 모델은 주로 영어 데이터로 학습되어 튀르키예어와 같은 교착어에서는 기대만큼의 성능을 보이지 못하는 경우가 많습니다. Cere-Gemma2-9b는 이러한 격차를 줄이기 위해 Cerebrum Tech가 미세 조정한 모델입니다.
모델 소개
Cere-Gemma2-9b는 약 90억 개의 매개변수를 갖춘 언어 모델입니다. 많은 매개변수 덕분에 다음과 같은 복잡한 언어 작업에 효과적입니다.
- 긴 텍스트의 이해와 요약
- 자연스럽고 유창한 텍스트 생성
- 언어 간 번역
- 질의응답 및 대화 시나리오
테스트 결과, 이 모델은 튀르키예어에서 다른 언어 모델보다 뛰어난 성능을 보였습니다.
사용 방법
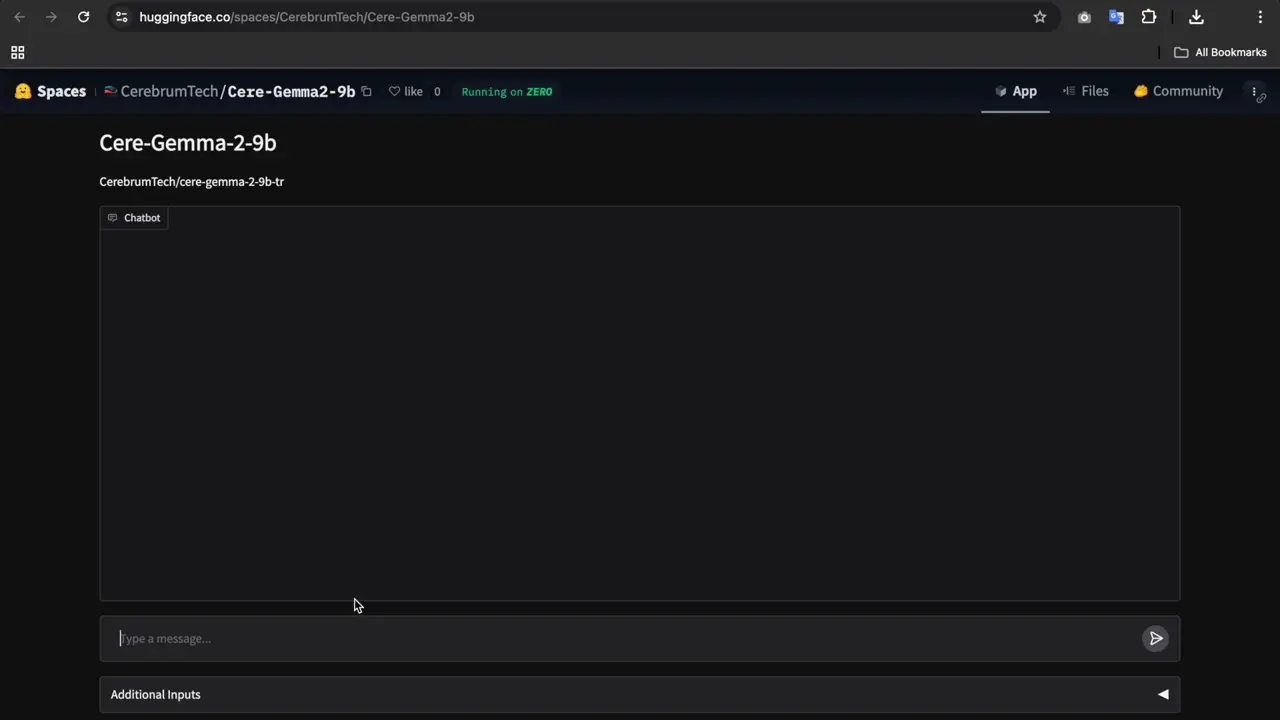
모델은 Hugging Face Spaces 플랫폼에서 호스팅됩니다. 온라인 데모를 통해 모델을 직접 테스트하고 기능을 살펴본 뒤 자신의 애플리케이션에 통합할 수 있습니다.
앞으로의 계획
우리는 새로운 작업과 산업별 요구에 맞춰 Cere LLM 제품군을 계속 발전시키고 있습니다. 프로젝트에 모델을 활용하는 방법을 논의하고 싶다면 info@cerebrumtechnologies.com으로 연락해 주세요.