Physical AI
Physical AI'da model seçimi işin kendisiyle başlar
Fiziksel sistemlerde doğru yanıt yetmez; ne zaman ve hangi donanımla eyleme dönüştüğü de önemlidir. Model seçimine, token ekonomisine ve VLM/VLA mimarilerine sahadan bakıyoruz.
 Alp Eren ÖzalpAr-Ge ve Yazılımdan Sorumlu Başkan Yardımcısı
Bir robot, hareket eden bir parçanın yerini doğru belirlese bile onu tutmak için harekete geçtiğinde geç kalmış olabilir. Ekranda doğru sayacağımız bir yanıtın fiziksel ortamda işe yaraması, ne zaman ve hangi donanımla eyleme dönüştüğüne de bağlı. Bu yüzden Physical AI'da model seçimine işin gerektirdiği yetenekleri belirleyerek başlıyoruz. Her kararı en büyük modele bırakmak, görev boyunca harcanan tokenların ve kullanılan donanımın karşılığını alacağımız anlamına gelmiyor.
Cerebrum Tech olarak sigorta sektöründeki müşterilerimizin oto hasar tespiti senaryolarında Qwen/Qwen3.8-27B modelini fine-tune ederek %95 doğrulukla Claude Opus 5.5 düzeyini yakaladık ve aksiyon sürelerinde %50 oranında hızlanırken, token maliyetini %80 oranında düşürdük. Bu deneyim, göreve uyarlamanın model seçiminde ne kadar belirleyici olabildiğini gösterdi. Devam eden Physical AI Ar-Ge çalışmalarımıza da bu bakışla yaklaşıyoruz. Algılama ve hareket planlama gibi farklı işler için gereken doğruluğu, gecikmeyi ve donanım ihtiyacını birlikte değerlendiriyoruz. Token ekonomisini de yerini alacağımız sistem ile maliyetleri mukayese etmek için ele alıyoruz.
Token fiyatından görev maliyetine
Token ekonomisini birim fiyat üzerinden konuşmak kolay. Oysa ucuz bir yanıt, işin ucuza tamamlandığı anlamına gelmiyor. Tekrar denemeler, insan kontrolü ve hatalı çıktıyı düzeltmek için harcanan zaman, doğru karar başına toplam maliyeti değiştirebilir. Daha güçlü bir modelin tek seferde tamamladığı işi daha küçük bir model birkaç denemede bitiriyorsa fiyat tablosundaki avantaj ortadan kalkabilir.
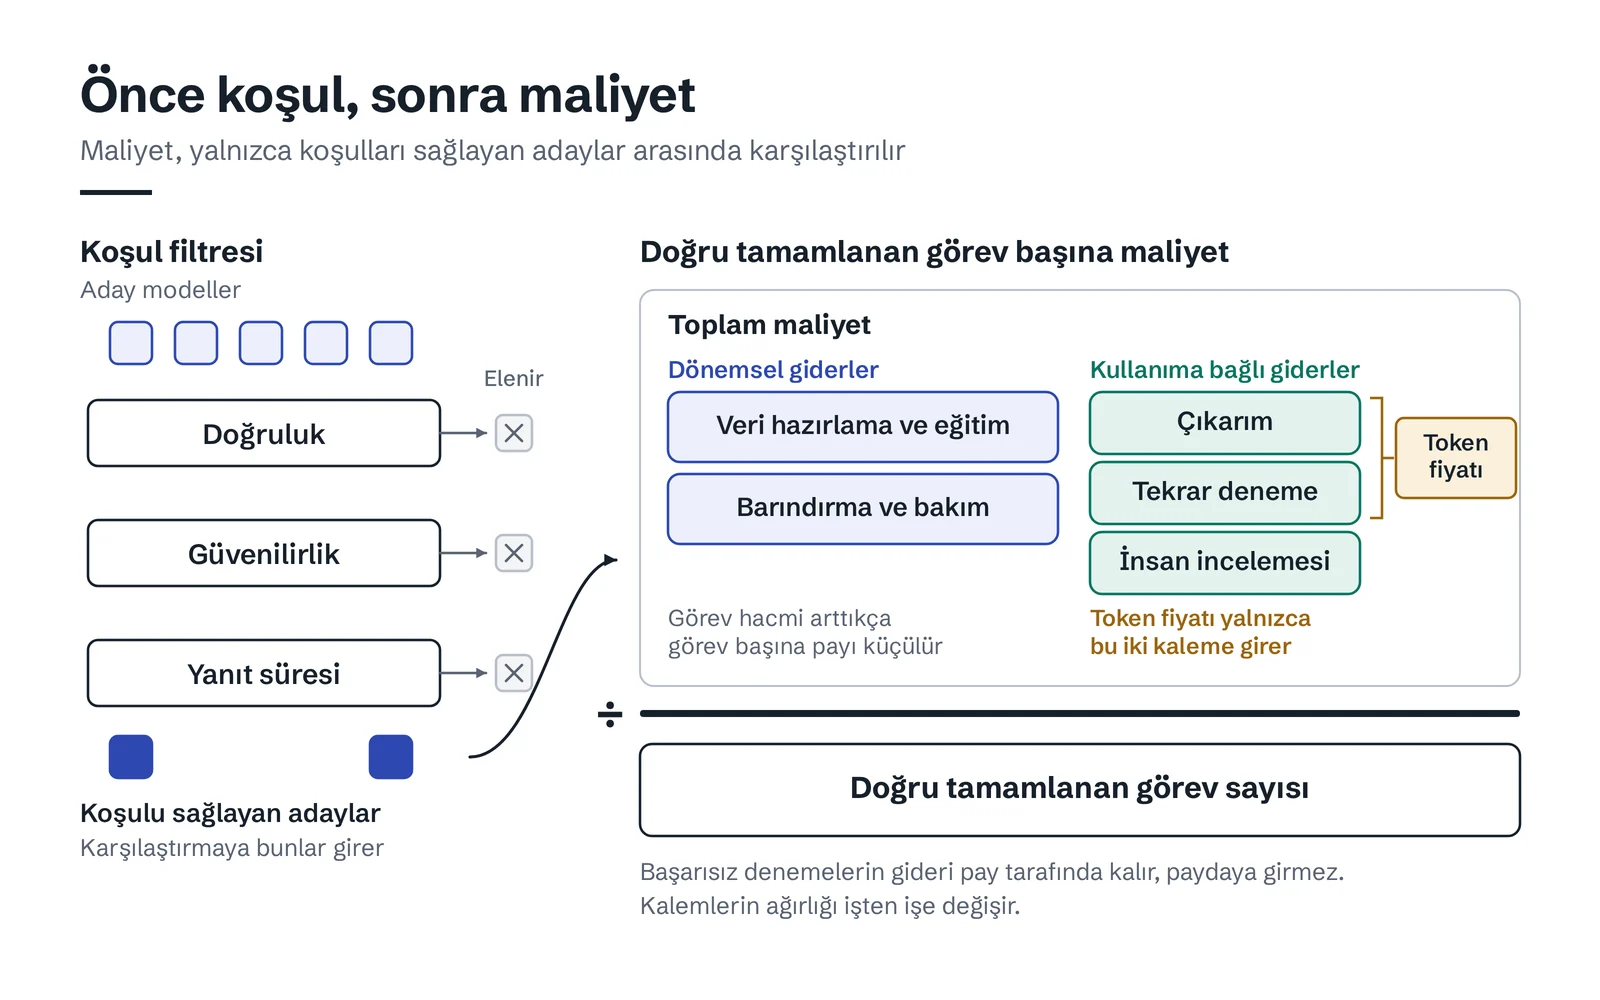
Karar verirken önce görevi ve kabul edilemeyecek hataları tanımlıyoruz. Ardından gereken doğruluk, güvenilirlik ve yanıt süresini karşılamayan seçenekleri eliyoruz. Maliyetleri, bu koşulları sağlayan modeller arasında karşılaştırıyoruz. Fiziksel sistemlerde güvenlik koşullarını daha düşük maliyet uğruna gevşetmeyi bir seçenek olarak görmüyoruz.
Fine-tuning de her durumda ekonomik değil. Veri hazırlamanın ve eğitimin başlangıç maliyeti var; barındırma ve bakım giderleri ise kullanım boyunca sürüyor. Görev yeterince tekrarlanıyorsa uzmanlaştırma yatırımı karşılığını verebilir. Hacim düşükse, iş sık değişiyorsa veya veri hazırlamak pahalıysa güçlü bir genel model daha ekonomik kalabilir. Oto hasar çalışmamız, göreve uyarlamayı neden seçenekler arasında tuttuğumuzu açıklıyor. Başka bir işte ise seçimi yeniden değerlendirmek gerekiyor.
Physical AI'da maliyeti hesaplarken tamamlanan fiziksel görevi de esas almak gerekiyor. Robotun kaç kez kavrama denediği, ne kadar beklediği ve operatörün ne sıklıkta müdahale ettiği işletme maliyetine yansıyor. Modelin çıkarım maliyetini azaltırken üretim çevrimini uzatmak, toplamda daha pahalı bir sistem ortaya çıkarabilir.
Görüntüyü anlamak, hareketi üretmek
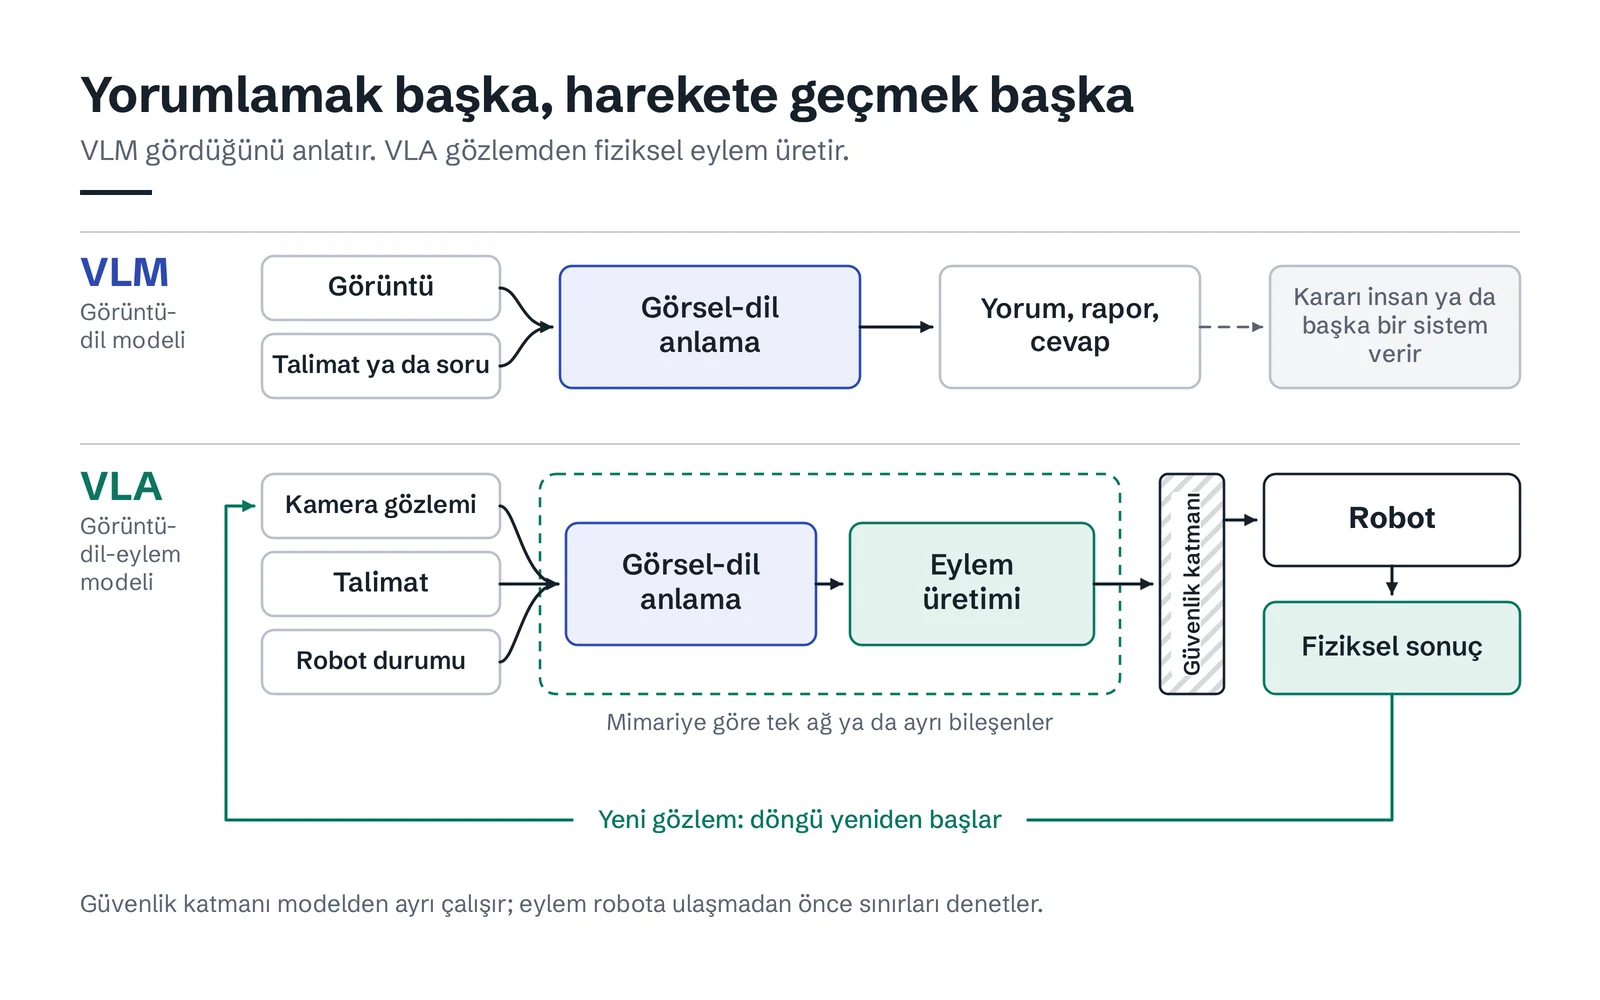
Görsel-dil modelleri, yani VLM'ler, görüntüdeki içeriği dil ile ilişkilendirerek anlamlandırıyor. Görsel-dil-eylem modelleri olan VLA'lar ise görsel ve dilsel bilgiyi robotun eylemlerine bağlıyor. Bir parçayı tanımakla onu uygun kuvvetle kavramak arasında, hareket boyunca sürekli güncellenmesi gereken bir kontrol süreci var. Physical AI çalışmalarımızda modelin yeteneklerini, donanım ve kontrol süreçleriyle birlikte değerlendiriyoruz.
Dış araştırmalarda da farklı mühendislik sorularına yanıt aranıyor. OpenVLA'nın Franka deneylerinde, parametrelerin yalnızca %1,4'ünü güncelleyen LoRA yöntemiyle tam fine-tuning düzeyine ulaşılması, uyarlama için gereken eğitim kaynakları açısından dikkat çekici. Bu bulgu, modele göreve özel yetenek kazandırmanın maliyetini değerlendirmek açısından önemli. Çıkarımın ne kadar kaynak gerektirdiğini ise ayrıca ölçmek gerekiyor.
Hugging Face'in SmolVLA çalışmasında başka bir yaklaşım öne çıkıyor: Robot bir hareketi tamamlarken sonraki hareket hesaplanıyor. Böylece bekleme süresini azaltmak için model boyutunun yanında hesaplamanın zamanlaması da ele alınıyor. Bu örnek, Physical AI mimarisini değerlendirirken model seçimiyle hesaplamaların nasıl düzenlendiğine birlikte bakmamız gerektiğini gösteriyor. Daha küçük bir model kullanmak, tek başına hızlı bir robot elde etmeye yetmiyor.
Saha, değerlendirmeyi değiştiriyor
Figure'ın BMW tesisindeki çalışmasına ilişkin paylaşımı, fiziksel sistemlerde donanımın ne kadar belirleyici olduğunu gösteriyor. Figure 02'nin görevi sac parçaları kaynak fikstürüne yerleştirmekti. Şirket, 1.250 saati aşan çalışmada 90 binden fazla parçanın yüklendiğini bildirdi. Aynı paylaşımda ön kolun başlıca donanım arıza noktası olarak belirtilmesini de üretim rakamları kadar önemli buluyoruz.
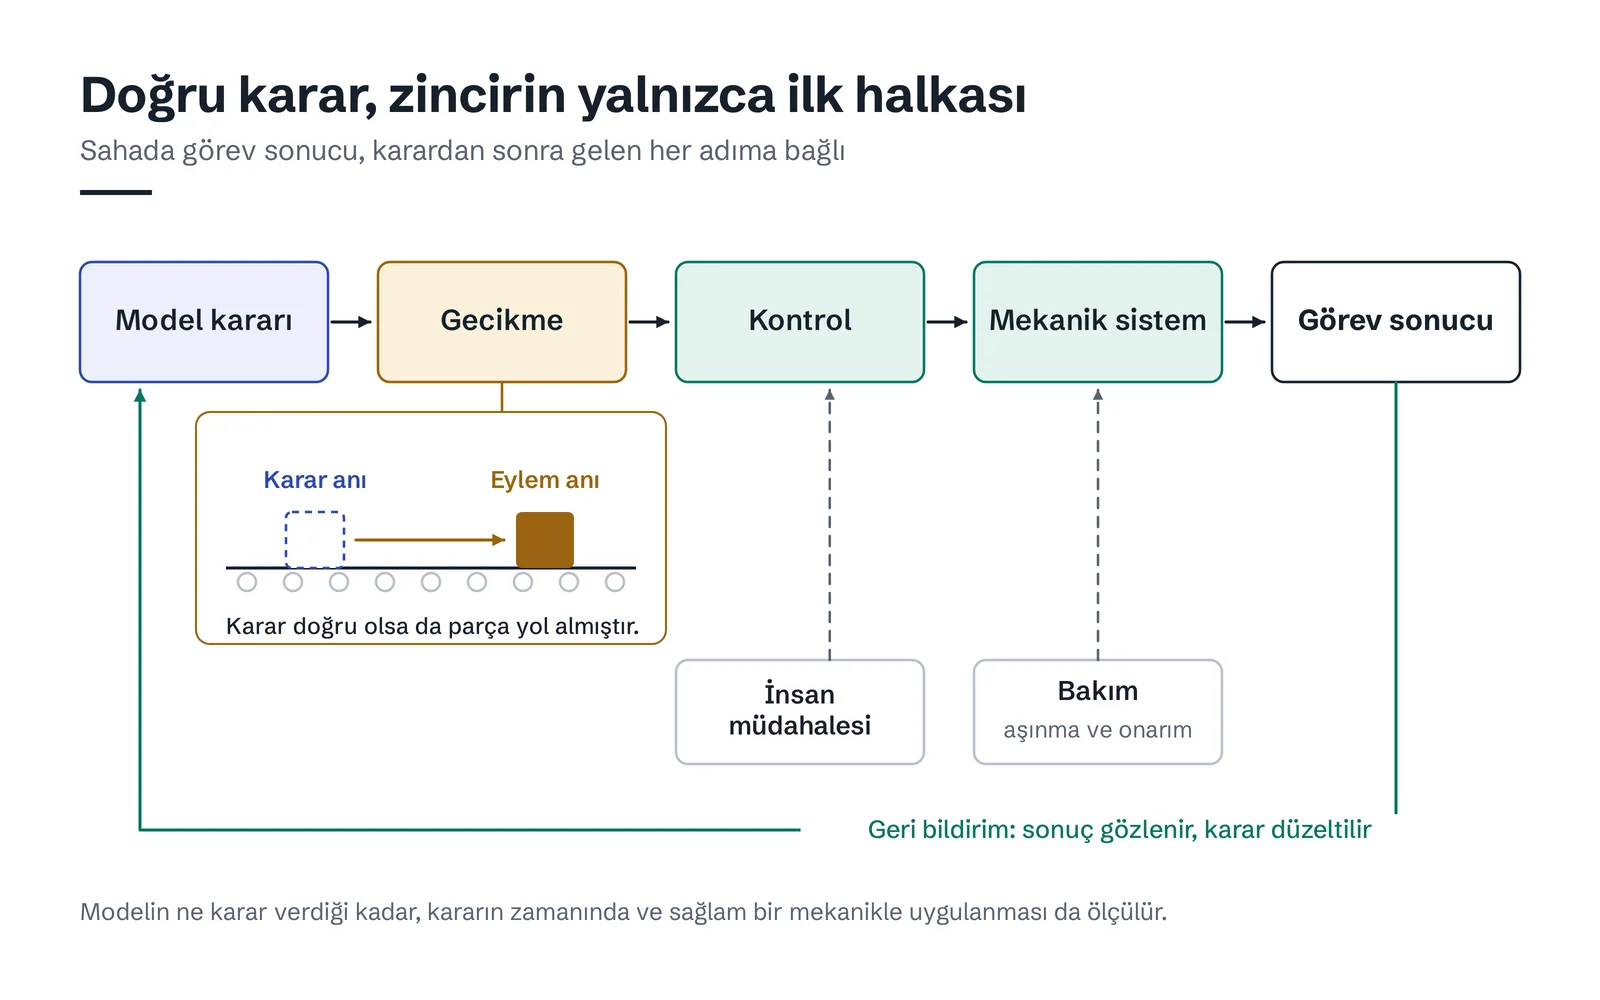
Bir modelin görevi doğru planlaması, mekanik dayanıklılık sorununu çözmüyor. Bakım ihtiyacı ve müdahale süresi, sistemin günlük kullanılabilirliğini belirliyor. Güvenlik de planlama modeline bırakılamaz; hareketleri doğrudan yöneten kontrol sistemleri ve donanımdaki güvenlik mekanizmalarıyla birlikte tasarlanmalı. Physical AI çalışmalarımızda bu yüzden model performansını ve sistemin güvenilirliğini ayrı ayrı değerlendiriyoruz.
Araştırmalarda hâlâ zorlanılan konulardan biri, öğrenilen becerilerin değişen ortamlarda da kullanılabilmesi. Nesnenin konumu veya ışık değiştiğinde robot görevi sürdürebiliyor mu? Beklemediği bir temasla karşılaştığında nasıl davranıyor? Bu sorular, veri çeşitliliğinin neden gerekli olduğunu açıklıyor. Tek bir düzenekte alınan sonucun farklı çalışma koşullarında da geçerli olması için ayrıca çalışmak gerekiyor.
Beklentimiz görev paylaşımının artması
Önümüzdeki dönemde güçlü planlama modelleriyle yerelde çalışan uzman hareket modellerinin birlikte kullanıldığı mimarilerin yaygınlaşmasını bekliyoruz. Ortamı yorumlayan model ile anlık geri bildirime hızla yanıt veren modelin aynı olması şart değil. Görev paylaşımı, hesaplama kaynaklarını ihtiyaca göre ayırmaya ve ağ bağlantısına bağımlılığı azaltmaya yardımcı olabilir. Bunun için modeller arasındaki iletişimi ve hata yönetimini de doğru kurmak gerekecek.
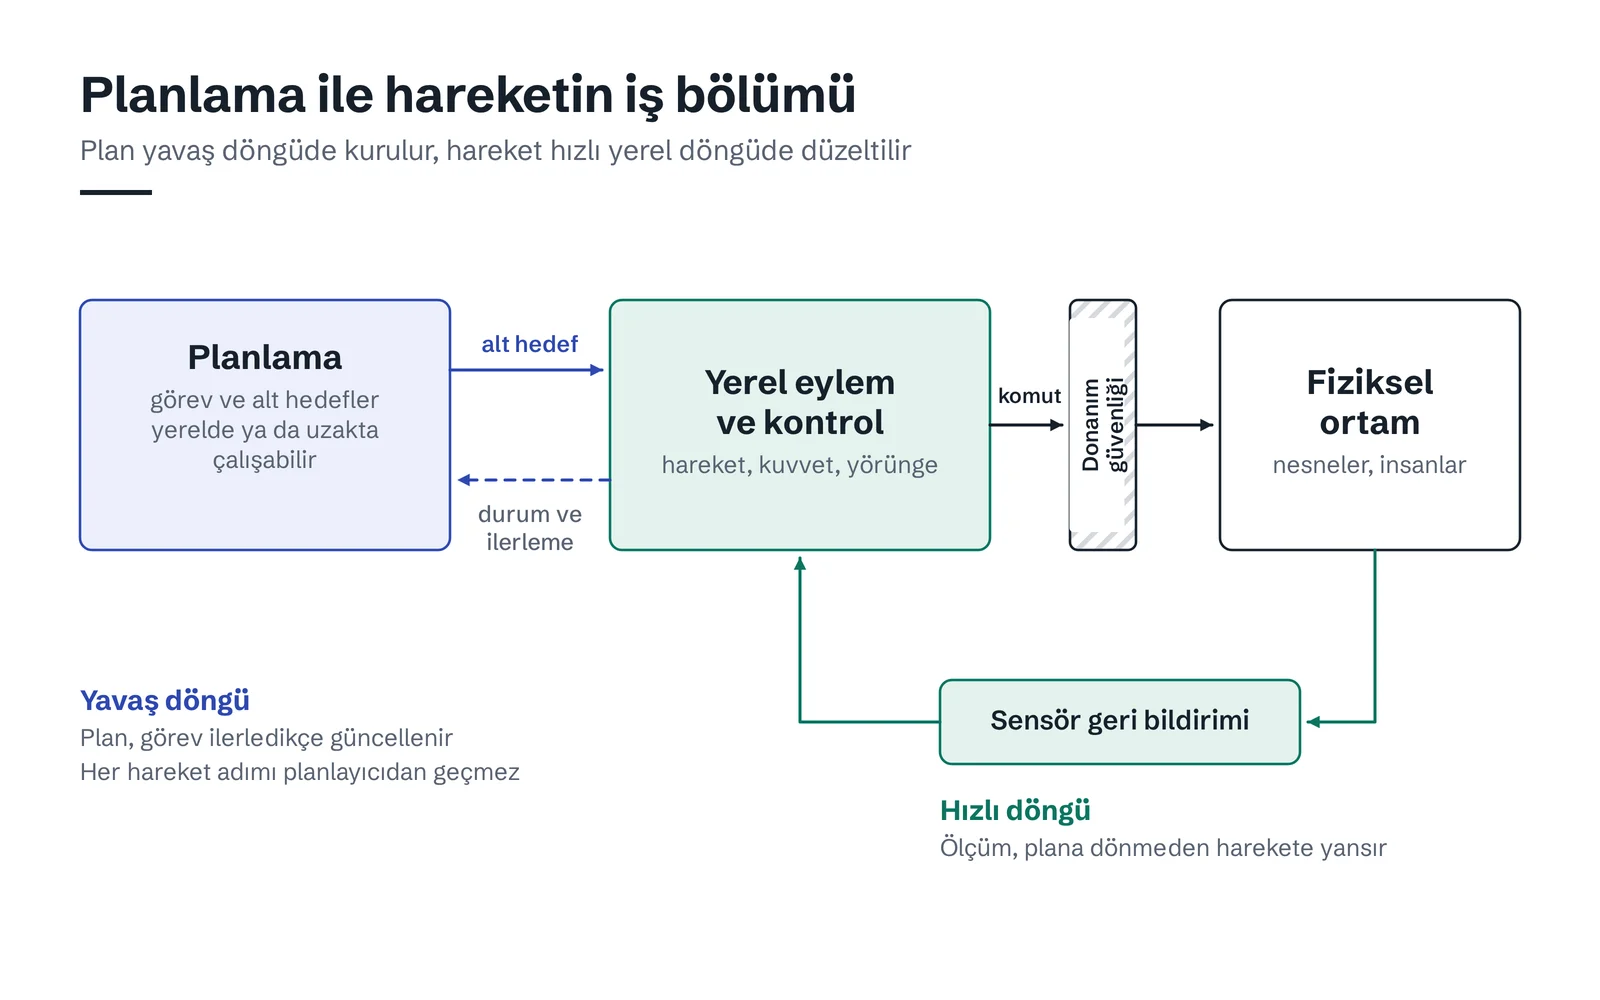
Simülasyonun eğitimde daha fazla kullanılacağını da öngörüyoruz. Farklı koşulları her seferinde gerçek donanımı riske atmadan denemek, öğrenme sürecini destekliyor. Ancak temas, aşınma ve gecikme gibi etkenlerin etkisini gerçek donanımda doğrulamak yine gerekecek. Becerilerin yeni ortamlarda da kullanılabilmesi için eğitim verilerini çeşitlendirmek ve sahadan gelen geri bildirimleri öğrenme sürecine katmak belirleyici olacak.
Cerebrum Tech olarak Physical AI araştırmalarımızı bu sorularla sürdürüyoruz. Oto hasar çalışmasında gördüğümüz uzmanlaştırma olanaklarını, fiziksel görevlerin farklı kısıtlarını dikkate alarak değerlendiriyoruz. Modelin yetenekleri kadar, donanım ve çalışma koşullarıyla nasıl uyum sağlayacağını da anlamaya çalışıyoruz. Teknik tercihlerimizi, görevin gerektirdiği doğruluk ve güvenlik koşullarıyla toplam maliyeti birlikte değerlendirerek şekillendirmek istiyoruz.
Kaynaklar
- OpenVLA — araştırma sitesi ve fine-tuning deneyleri
- Hugging Face — SmolVLA: Efficient Vision-Language-Action Model
- Figure — F.02 Contributed to the Production of 30,000 Cars at BMW
- Google DeepMind — Gemini Robotics 2
- Google DeepMind — Gemini Robotics On-Device 2 model kartı
- Nikhil Sawane — When Fine-Tuning Hurts (15 Aralık 2025)
- Xavier O’Keefe — Fine Tuning SmolVLA for New Environments (21 Ocak 2026)
- Ville Kuosmanen — Sharing GPUs in AI Robotics with CUDA Streams (13 Ekim 2025)
- LG AI Research — RFM: Action-Oriented Intelligence for Physical AI (26 Haziran 2026)
- Ahabb Sheraz — Anatomy of VLA: Inside SmolVLA (1 Ağustos 2026)
- Shivam Kumar Singh — Teaching an SO101 to sort blue candies (19 Ekim 2026)